AI 视频分析平台
Vision Hub · AI 视频行为分析平台
拖拽式算法编排驱动视频分析全链路,从摄像头接入、多模型推理到事件告警与智能检索。


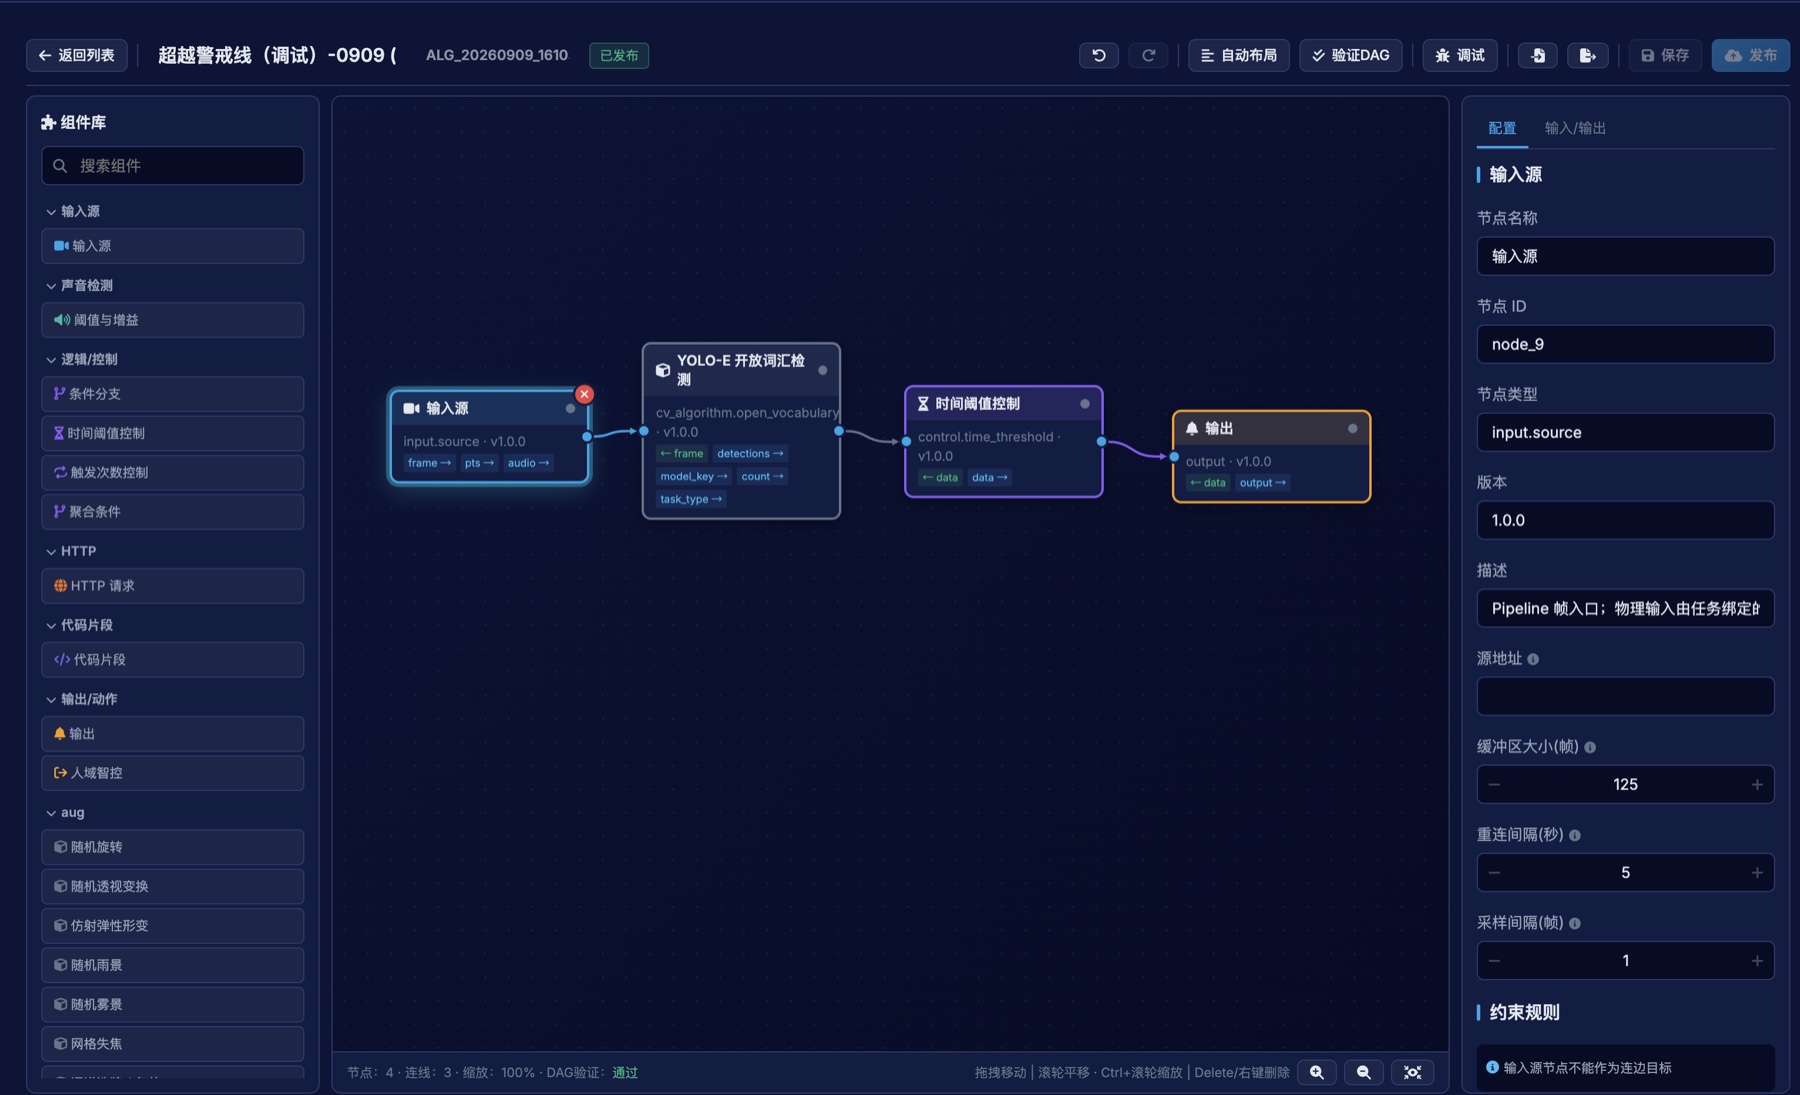
一个面向视频监控场景的行为分析平台,用拖拽式算法编排驱动整条链路:摄像头接入 → 视频解码 → 多模型推理 → 事件告警 → 媒体取证 → 智能检索。
事件详情页将检测结果、抓拍与视频、事件信息、AI 分析和处置记录汇集到一个工作界面。数据人工判定页则把样本列表、AI 标注和人工修订放在一起,支持逐张核验与有效性判定。
把算法链路变成可拖拽的图
平台的核心抽象是编排:把"取哪路流、用什么模型、满足什么条件算事件、触发后做什么"拆成 38 种节点类型,在画布上连成有向图,保存后下发给推理引擎执行。
画布是自研的 DAG 编辑器:组件面板拖节点、连线即成链路,属性面板按节点元数据动态生成表单,支持节点右键菜单与逐节点调试仿真——现场配置一条新链路,可以先单步试跑、看每个节点的中间输出,再审核发布。
规模如今是:后端约 770 条接口路由、Python 约 41 万行;前端约 26 万行、25 个功能模块;一个平台里跑着 6 个以上独立进程(平台 API、推理引擎、训练服务、运维端口,以及负责事件、回执、定时任务的多个 Worker)。
一套代码,适配多种算力
现场部署的硬件差异极大——有的是带独立显卡的服务器,有的是华为昇腾 Atlas 加速卡,有的只能跑 CPU。所以推理层做了多后端抽象:同一份权重可以导出 ONNX、TensorRT 与昇腾 OM/Engine 多种格式,运行时按设备能力选择;解码侧同样是 NVDEC 硬解、次选方案与 CPU 软解的降级链,GPU 解出的码流直接以 Surface 态进推理,fallback 才落回内存 BGR。
数据层也留了后路:PostgreSQL 为主,可切 MySQL 与达梦 DM8;流媒体侧对接 GB/T 28181 国标平台。
不同后端统一输入、输出与节点契约,让设备适配留在推理层,业务编排可以继续复用。
项目中遇到的问题与解决结果
事件偶发延迟:从死连接追到重放等待
2026 年 8 月的项目排障记录中,同一事件链路正常入账约 100–450 ms,异常时却稳定落在 30.6–32.3 秒。对照事件收件记录和媒体发布日志,原因落在 RabbitMQ 长连接:空闲期间缺少心跳维护,下一次媒体任务发布碰到已断开的连接,失败后进入固定 30 秒的收件重放等待。
当前实现由媒体派发线程维护连接心跳,空闲超过 30 秒主动重建;发布异常后重建连接,按 0.1 / 0.3 秒间隔最多追加两次尝试。收件重放的默认首次等待也从 30 秒缩短到 5 秒。这是重放间隔的变化,修复后的端到端入账延迟仍需由运行日志统计。回归用例覆盖断连重试、连续失败、空闲重建和心跳维护。
大屏重复拉流:多个画面共享一个会话
同一个摄像头会同时出现在三维场景和告警实时画面中,各组件独立播放会重复建连;摄像头编码和浏览器能力差异又会造成黑屏或断流后冻结。
播放器统一管理 WebRTC → FLV → HLS → WASM 软解的降级路径,并按流地址共享底层会话。H.265 在浏览器无法硬解时转到软解;同流多个消费者复用同一份画面与播放状态,最后一个消费者离开后释放资源。连接规模由每个画面一个会话,收敛为每个流地址一个会话(N → 1);现有单测用两个消费者断言只创建一个引擎,并检查释放、重连和降级状态同步。
旧浏览器样式失效:从逐页修补到产物检查
项目需要在旧版 Chromium 和安全浏览器中运行。初次 Chrome 108 兼容审计发现,14 个文件、106 处有效 color-mix() 调用会影响主题色、背景、边框与检测框;编排连线的箭头也会因 SVG 上下文颜色不被识别而变黑。
这轮整改将上述颜色调用改为 RGB token、rgba() 与透明度属性,当次审计范围内有效调用从 106 处清到 0;箭头改为按连线颜色生成独立 marker,并完成 Win7 + Chrome 108 专项实机验证。
后续安全浏览器适配把构建目标下调到 Chrome 75,将 Tailwind 切到 3.4,集中补齐 4 项运行时 API,并加入 JavaScript / CSS 产物扫描和旧内核关键路径冒烟。适配范围明确排除 6 个大屏及配置路由,发布前用同一份候选产物完成真实终端验收。
算法节点库:从视觉检测到多模态
算法节点库是 Vision Hub 的核心模块,由我实现检测、判定与规则三个层次。
检测层:七种视觉算法
通用目标检测、开放词汇检测、关键点检测、人脸检测、人脸特征、人脸识别、深度估计,共用节点端口和数据契约。不同算法可以在同一张编排图中组合,调用方不需要为每个模型单独设计链路。
其中开放词汇检测基于 YOLOE,支持按指定类别名称检测目标——现场要加一类新判定,往往是"拖一个节点、改一处配置",而不是改代码发版。
增强层与多模态:38 类节点
检测与判定之外,节点库还有 17 种图像增强算子(雾雨噪点、透视旋转、运动模糊等,为训练与仿真造数据),条件、时间阈值、触发计数、聚合四类控制流,HTTP 与代码节点(外部系统联动和自定义逻辑),以及 ASR、LLM、NLP、声音门限与多模态模型节点——同一张图里可以既有视觉检测,也有语音与语言理解。
判定层:限定目标与关注区域
同一条视频分析链路可能串联多个算法,但各节点的目标类别、阈值和关注区域不同。检测节点支持类别筛选、分类置信度阈值与检测框面积过滤,再按 ROI 限定有效区域。
ROI 可以绑定具体算法节点,也可以作为多个节点共用的区域;未绑定节点的存量配置继续生效。空间过滤提供检测框上、中、下、左、右 5 种参考点,按「反选区优先排除、正选区取并集」处理,避免一个节点的区域配置误作用到整条链路。
规则层:时序与触发
「持续 10 秒才算」「连续触发 3 次才告警」「两个条件同时满足」由条件分支、时间阈值、触发计数与聚合条件等规则节点表达,和检测、判定节点组合成完整的分析链路。
人工判定:误报的终点,训练的起点
推理再准也有误报。平台带了一套自研的人工判定工具——前端最大的功能模块(87 个源文件)。按判定计划批量组织 AI 检测与人工复核任务,计划带未开始、运行、暂停、完成、失败的全生命周期状态与监控面板。
复核界面把样本列表、AI 预标注框和人工修订放在一起:人工框可增删改、可撤销,逐张给出有效 / 无效结论。判定过的有效样本进入数据集(上传、拆分、合成),再经 17 种增强算子与文生图任务扩充难例,最终回流给训练子系统。
训练、取证与验证
平台内置了独立的模型训练子系统:数据集拉取、YOLO 训练、评估与权重管理自成服务,训练产物自动导出 ONNX / 昇腾 OM / Engine 多格式回灌推理。媒体取证下沉到码流层:压缩音视频进入环形缓冲,按事件时间窗定位关键帧,先重封装,再用 ffmpeg 精剪到请求窗口。
事件首报与媒体制备分开:先上报结构化事件,图片和视频完成后按事件标识补齐。验证围绕连接自愈、媒体乱序与重复补齐、播放器会话共享和旧浏览器关键路径展开。
检测结果经过类别、空间与时序规则,才能形成符合业务条件的事件。
(故障耗时来自项目排障记录;重放间隔来自当前代码默认值,会话复用由实现与单测契约核对,颜色整改数量来自当次兼容审计。已隐去客户与内网信息。)
本文数据来自生产实践,已隐去客户与内网信息。